Category: blog

  • 關於 CitePress WordPress Plugin

    CitePress

    CitePress 是一個 WordPress plugin,用來從研究者的 ORCID record 建立格式一致的學術著作清單。

    Current version: 0.6.2
    Tested with: WordPress 7.1 / PHP 7.4+
    Author & Maintainer: Ying-Tsong Chen 陳盈璁 (with ChatGPT)
    License: GPLv2 or later


    Contents


    What CitePress Does

    CitePress uses ORCID to determine which works belong to a researcher, then uses DOI and other identifiers to obtain more consistent bibliographic metadata.

    Its basic philosophy is simple:

    Missing information is better than confidently displaying incorrect information.

    Starting with version 0.4.0, CitePress is fully standalone and does not require Researcher Profiles for ORCID or its CSS.


    How It Works

    ORCID
      ↓
    Works & identifiers
      ↓
     DOI ─────→ Crossref
                   ↓
           bibliographic metadata
                   ↓
              Europe PMC
           (fallback if needed)

    ORCID identifies the researcher and works. Crossref is the primary source for DOI-based bibliographic metadata. Europe PMC is used conservatively to fill missing fields or help resolve selected older records.

    For genuine non-DOI publications, CitePress can use metadata stored directly in ORCID and display an EID when available.


    Installation & Setup

    1. In WordPress, go to Plugins → Add Plugin → Upload Plugin.
    2. Upload the CitePress ZIP file and activate the plugin.
    3. Apply for ORCID Public API credentials through ORCID Developer Tools.
    4. Copy your Client ID and Client Secret.
    5. Go to Settings → CitePress and paste both values.
    6. Save the settings.

    The Client ID and Client Secret are not your ORCID password. CitePress uses them only to obtain /read-public access and read publicly visible ORCID records. It does not modify your ORCID record.


    Shortcodes

    Journal articles

    [citepress orcid="0000-0003-1337-4127" type="journal-article"]

    Preprints

    [citepress orcid="0000-0003-1337-4127" type="preprint"]

    Replace the example ORCID iD with the ORCID of the researcher whose publications you want to display.


    Supported Publications

    CitePress v0.4.2 has been tested with two ORCID work types:

    • journal-article
    • preprint

    For journal articles, CitePress can display:

    • title
    • authors
    • the researcher’s own name in bold
    • journal
    • publication year
    • volume
    • issue
    • pages or article number
    • DOI
    • EID fallback for genuine non-DOI records

    A typical citation looks like:

    Establishment and characterization of a Wolbachia (wAlbB)-infected Aedes aegypti line (Tw-Kao) for dengue control
    Hui-Ying Yu, Bo-Yu Chen, Ying-Tsong Chen, et al.
    PLOS Neglected Tropical Diseases 2026 20(5): e0014222
    DOI: 10.1371/journal.pntd.0014222

    Preprints are handled separately from journal articles. CitePress can identify supported preprint platforms such as bioRxiv, medRxiv, arXiv, ChemRxiv and Research Square.

    If the platform cannot be determined reliably, CitePress leaves it blank rather than guessing.


    Data Refresh & Cache

    CitePress does not run scheduled background synchronization or create a WordPress Cron job.

    Starting with v0.5.0, CitePress provides two refresh modes:

    Automatic — Lazy Refresh

    This is the default mode.

    CitePress caches publication metadata and refreshes expired data only when the publication page is requested.

    Page requested
          ↓
    Check cache
       ↙       ↘
     valid    expired
       ↓         ↓
     use it   fetch fresh data
                 ↓
            rebuild cache

    Different metadata have different cache lifetimes. ORCID works are normally cached for about one day, researcher/work details for up to seven days, while stable DOI metadata may be cached much longer.

    Nothing is synchronized in the background.

    Manual — Update Only When You Decide

    In Manual mode, successfully retrieved publication metadata does not expire automatically.

    The publication list remains unchanged until you explicitly request an update.

    This mode is useful when you prefer to keep a stable public publication list and update it only after you have reviewed or modified your ORCID record.

    Failed API lookups are still cached only temporarily, so a temporary network or external-service failure will not become permanent.

    Manual Update & Rollback

    Manual mode includes a simple one-level rollback system.

    When you click Prepare Manual Update, CitePress first saves the current publication metadata as the Previous Version, and then clears the active cache.

    Current publication data
              ↓
     Prepare Manual Update
              ↓
    Save as Previous Version
              ↓
    Clear active cache
              ↓
    Next publication-page request
              ↓
    Retrieve fresh metadata
              ↓
    New current publication data

    The actual update occurs the next time the publication page is requested.

    If the refreshed publication list is incomplete or otherwise unsatisfactory, go back to:

    Settings → CitePress

    and click:

    Restore Previous Version

    CitePress will restore the publication metadata saved immediately before the update.

    Only one previous version is retained. Each new manual update replaces the previous rollback snapshot.


    Notes & Limitations

    • CitePress depends on the quality of metadata available from ORCID, Crossref and Europe PMC.
    • If an older ORCID record has a DOI but the DOI is missing from ORCID, adding it directly to your ORCID record is usually the best solution.
    • Title-based DOI recovery is deliberately conservative; ambiguous matches are rejected.
    • Genuine non-DOI publications can fall back to ORCID contributors and EID where available.
    • Other ORCID work types may work, but only journal-article and preprint are currently tested and supported.
    • CitePress includes its own CSS and does not require another ORCID plugin for formatting.
    • Manual rollback retains only one Previous Version. It is intended as a simple safety net for publication updates, not as a full version-control or backup system.

    Why I Made CitePress

    CitePress 一開始其實不是什麼開發計畫。

    我只是懶得再手動維護自己的 publication list,所以找了一個 WordPress plugin,讓它從 ORCID 自動抓著作。用了之後,卻陸續發現一些自己想改的地方:我希望顯示作者、自己的名字要粗體、期刊資料要完整、preprint 要正確處理,遇到老文章缺 DOI 時也應該有合理的辦法。

    一開始只是請 ChatGPT 幫我修改原來的 plugin;改著改著,我突然想到:既然 ORCID 可以告訴我有哪些作品,DOI 又可以從 Crossref 取得書目資料,那何不乾脆按照自己想要的邏輯,重新做一個?

    於是就有了 CitePress。

    有趣的是,整個過程中我幾乎沒有寫一行 PHP。我做的事情,是不斷告訴 ChatGPT 「我想要什麼」:資料應該從哪裡來、什麼結果才合理、遇到例外怎麼處理,以及哪些事情寧可不知道,也不要亂猜。

    這讓我愈來愈覺得,AI 時代的「寫程式」正在變成一件不太一樣的事情。

    你不一定要先學會 PHP,才能做一個 WordPress plugin;但你仍然必須知道自己想解決什麼問題,也必須有能力判斷做出來的東西到底對不對。

    以前,我們得先學會電腦的語言,才能把想法告訴電腦。
    現在,開始可以直接把想法講清楚了。

    程式語言並沒有消失,只是慢慢退到了使用者看不見的地方。


    CitePress 0.6.2
    Ying-Tsong Chen 陳盈璁 (with ChatGPT)
    Licensed under the GNU General Public License v2 or later (GPLv2+).

  • 當細菌偷來的不只是抗藥基因

    當細菌偷來的不只是抗藥基因

    Plasmid-borne transcriptional regulator RamAp modulates Salmonella genes for environmental and host adaptation. https://doi.org/10.3389/fmicb.2026.1842592

    提到抗生素抗藥性,人們通常會想到細菌獲得某種「抗藥基因」,例如能分解抗生素的酵素,或把藥物排出細胞的外排幫浦。

    但事情其實可能比這更複雜。

    有些細菌的大型質體(plasmid)上,攜帶的不只是功能性的抗藥基因,而是一種能夠控制許多基因開關的「調控者」。

    我們研究的 RamAp,就是這樣的一個例子。

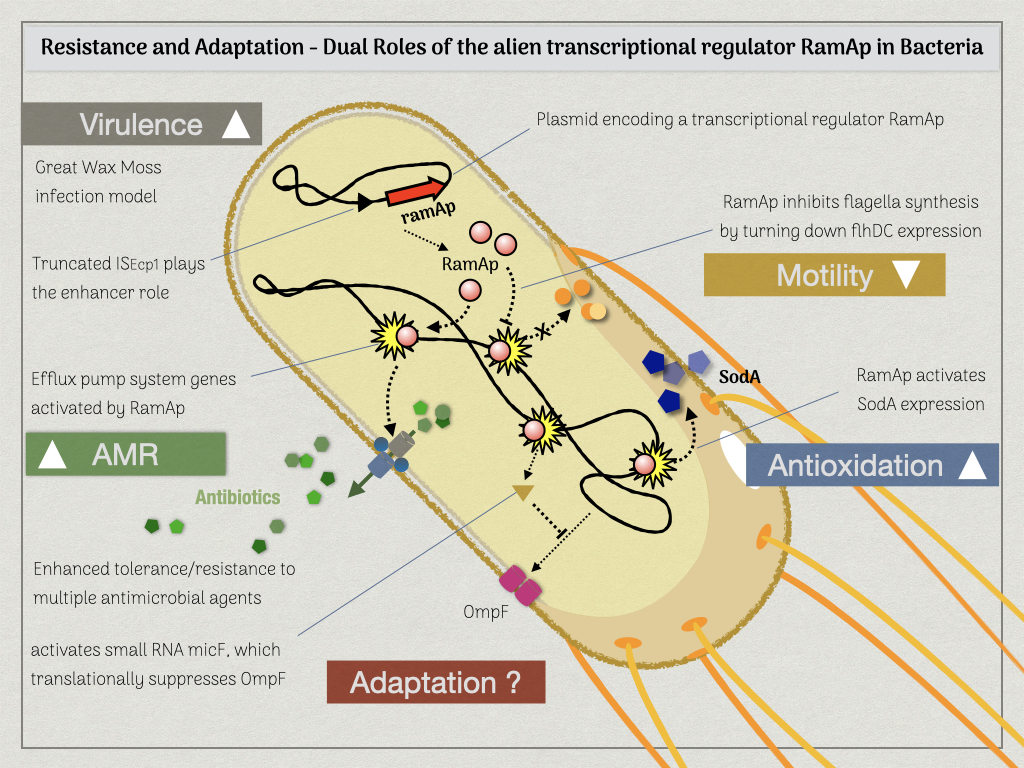
    RamAp 存在於沙門氏菌(Salmonella enterica)的大型 IncHI2 質體上。它本身不是抗藥酵素,也不是外排幫浦,而是一種 AraC family 的轉錄調控蛋白。換句話說,它比較像是一位「指揮官」,能夠影響細菌體內許多不同基因的表現。

    這件事之所以有趣,是因為它代表:細菌在水平基因轉移時,「偷來」的可能不只是某個單一功能,而是一個能夠重新改變原有基因調節網路的關鍵調控因子。

    我們早期的研究發現,RamAp 能夠活化與多重抗藥性有關的外排幫浦系統。但後續研究中,我們逐漸發現,它的影響遠遠超過抗藥性本身。

    透過 RNA sequencing、DNA 結合分析以及功能性實驗,我們發現 RamAp 會影響與氧化壓力防禦、細胞膜調控、鞭毛生成,以及致病相關特徵有關的基因。

    其中一個有趣的現象是:當 RamAp 存在時,細菌啟動了與抗藥性相關的外排幫浦系統,同時也提高了與氧化壓力防禦有關的能力;相對地,許多鞭毛相關基因的表現下降,細菌的游泳能力也變弱了。

    這看起來像是一種生理狀態的切換。鞭毛運動本身是一件高度耗能的事情,鞭毛也容易成為宿主免疫系統辨識細菌的標的;相較之下,外排幫浦與氧化壓力防禦系統的啟動,則可能更有利於細菌在抗生素與宿主免疫壓力下存活。

    更有意思的是,在 Galleria mellonella 感染模型中,帶有 RamAp 的細菌表現出較高的致病相關能力。這表示 RamAp 的影響並不只是「讓細菌比較抗藥」而已,而可能進一步改變細菌面對宿主環境時的生存策略。

    另一個有趣的地方是,RamAp 本身的表現,似乎又受到其上游一段與 ISEcp1 有關的移動元件序列所影響。

    ISEcp1 是細菌中常見、與抗藥基因移動有關的 insertion sequence(插入序列),經常出現在許多可水平轉移的抗藥性基因附近。在這個研究中,我們發現 RamAp 上游存在一段截短的 ISEcp1 序列,而這段序列能夠提升下游 RamAp 的轉錄表現。

    這代表這個移動元件可能不只是「搬運」基因而已,它本身還可能順帶提供促進基因表現的調控效果,使這個外來的調節子更容易在新的宿主細菌中被啟動。

    換句話說,細菌在水平基因轉移時,獲得的可能不是一組完整的新功能,而是一個足以重新佈局原有調控網路的關鍵節點。當這樣的調節子進入新的細菌宿主後,它可能透過影響既有的基因調控系統,逐漸改變細菌的抗藥性、生理狀態,甚至與宿主互動的方式。

    從基因體學的角度來看,這類可移動的調控因子,或許是細菌快速適應新環境與演化的重要機制之一。

  • From Idea to Genome: Reconstructing Wolbachia Using Adaptive Sampling

    From Idea to Genome: Reconstructing Wolbachia Using Adaptive Sampling

    從「讀取」到「選擇」:Adaptive Sampling 如何改變基因體定序的可能性

    我們最近將一項研究成果放上了 bioRxiv:https://doi.org/10.64898/2026.03.25.714109
    這項工作,其實從一個很單純的問題開始。

    胞內共生菌的基因體

    Wolbachia 是一種存在於昆蟲體內的胞內共生菌,在基礎研究與病媒控制中都相當重要。

    但在實務上,它一直有一個困難——

    它幾乎永遠被宿主的 DNA 淹沒。

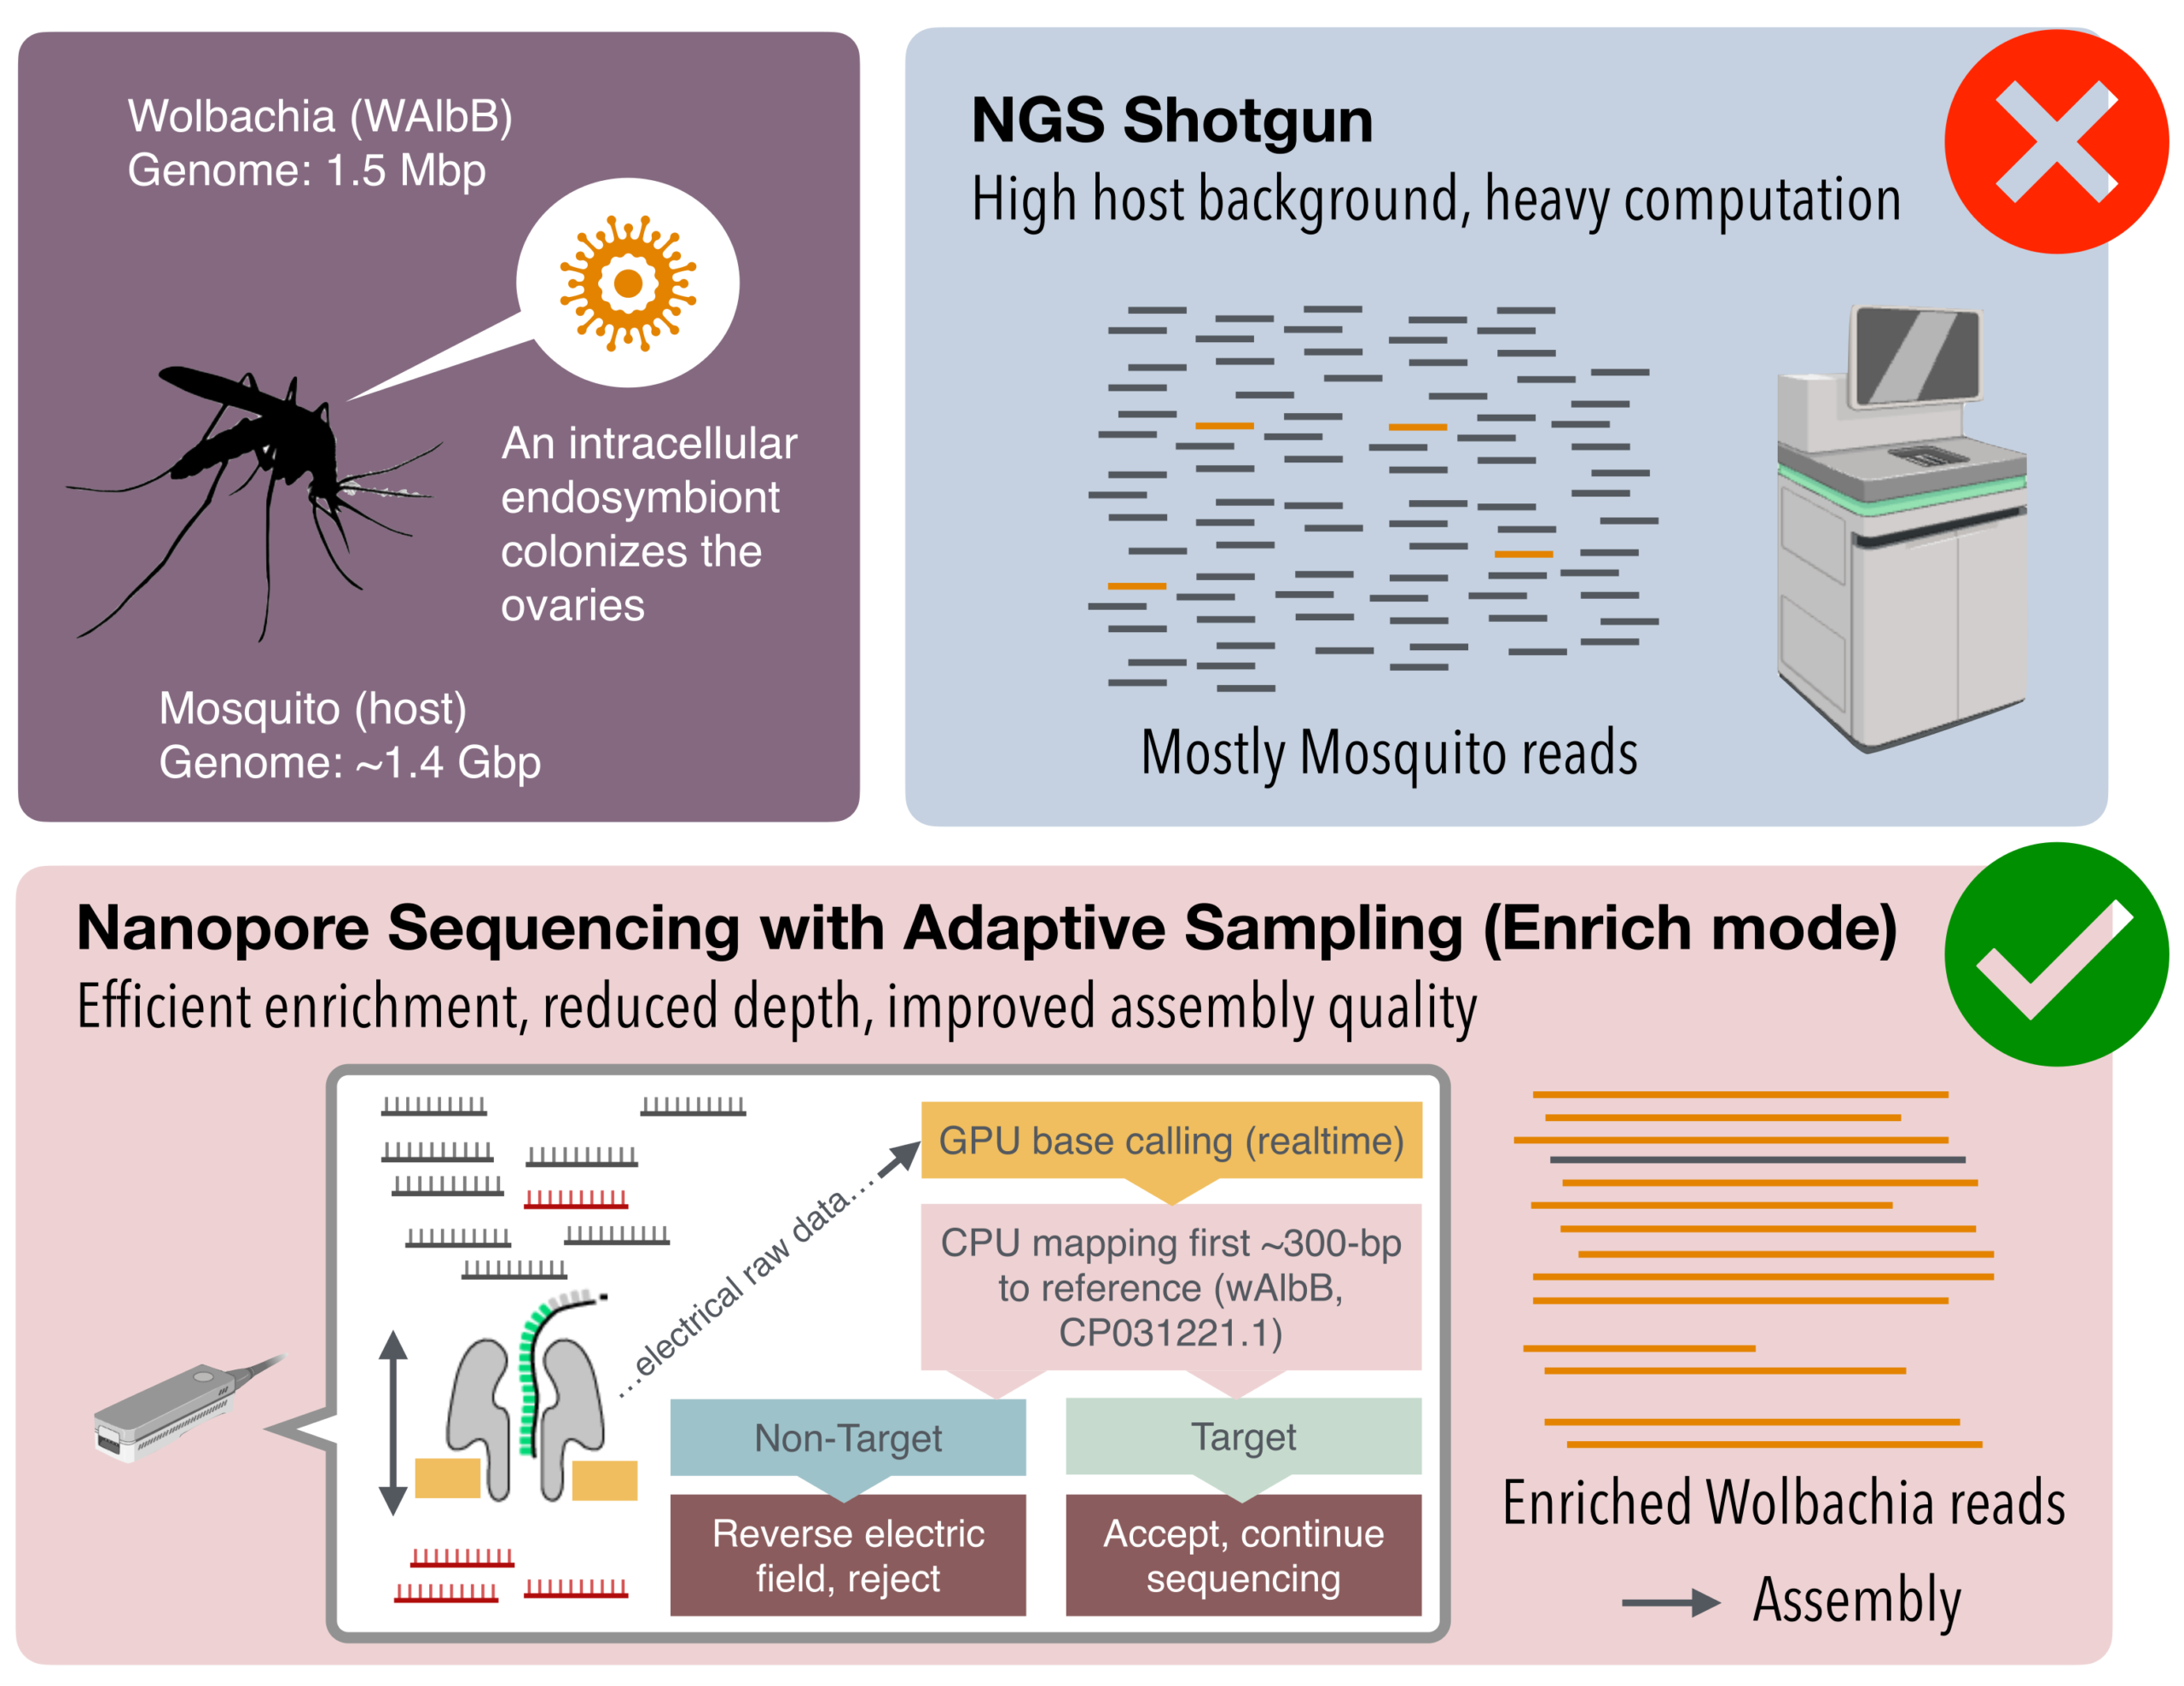
    Wolbachia只能長在細胞裡面,它並不像平常大腸菌那樣可以被分離出來用培養基培養。因為沒辦法把它獨自分離出來,當我們將整隻蚊子的 DNA 萃取進行定序時,得到的絕大多數的序列都會來自宿主本身。

    Wolbachia 的基因體約為 1.5 Mb,而蚊子的基因體則約為 1.4 Gb。

    這使得在一般 shotgun sequencing 下,讀到的幾乎都是蚊子的基因體,屬於Wolbachia 的訊號往往低到幾乎看不見。

    如果不能分離,那能不能「選擇」?

    事情的起頭大約是兩年前的春天,國衛院做病媒蚊研究的學者跟我提了一個問題「你有沒有興趣看看蚊子的Wolbachia基因體?」我知道這個很不容易,但開始思考一個問題:

    既然 Nanopore sequencing 可以在讀取 DNA 的過程中,即時判斷序列內容,那是否有可能在讀取的當下,只讀取我們想要的序列?

    這個想法,後來成為我們嘗試使用 adaptive sampling 的起點。

    Nanopore 的 adaptive sampling,最初主要是被設計用於targeted sequencing,
    例如針對特定基因區域或已知序列進行選擇性讀取。

    不過我們關心的是另一個問題:

    當目標不是一段已知序列,而是一整個被宿主 DNA 淹沒的基因體時,這樣的策略是否仍然有效?

    一段反覆修正與試誤的過程

    真正開始進行之後,我們很快發現事情並不單純(研究好像都是這樣)。

    這幾年來,實驗室的研究生們幾乎都參與了這個方向的探索。
    從最初的測試,到後來不斷調整條件、修正流程、排除問題,很多時候,其實不知道下一步會不會成功。

    只是慢慢把事情做清楚。

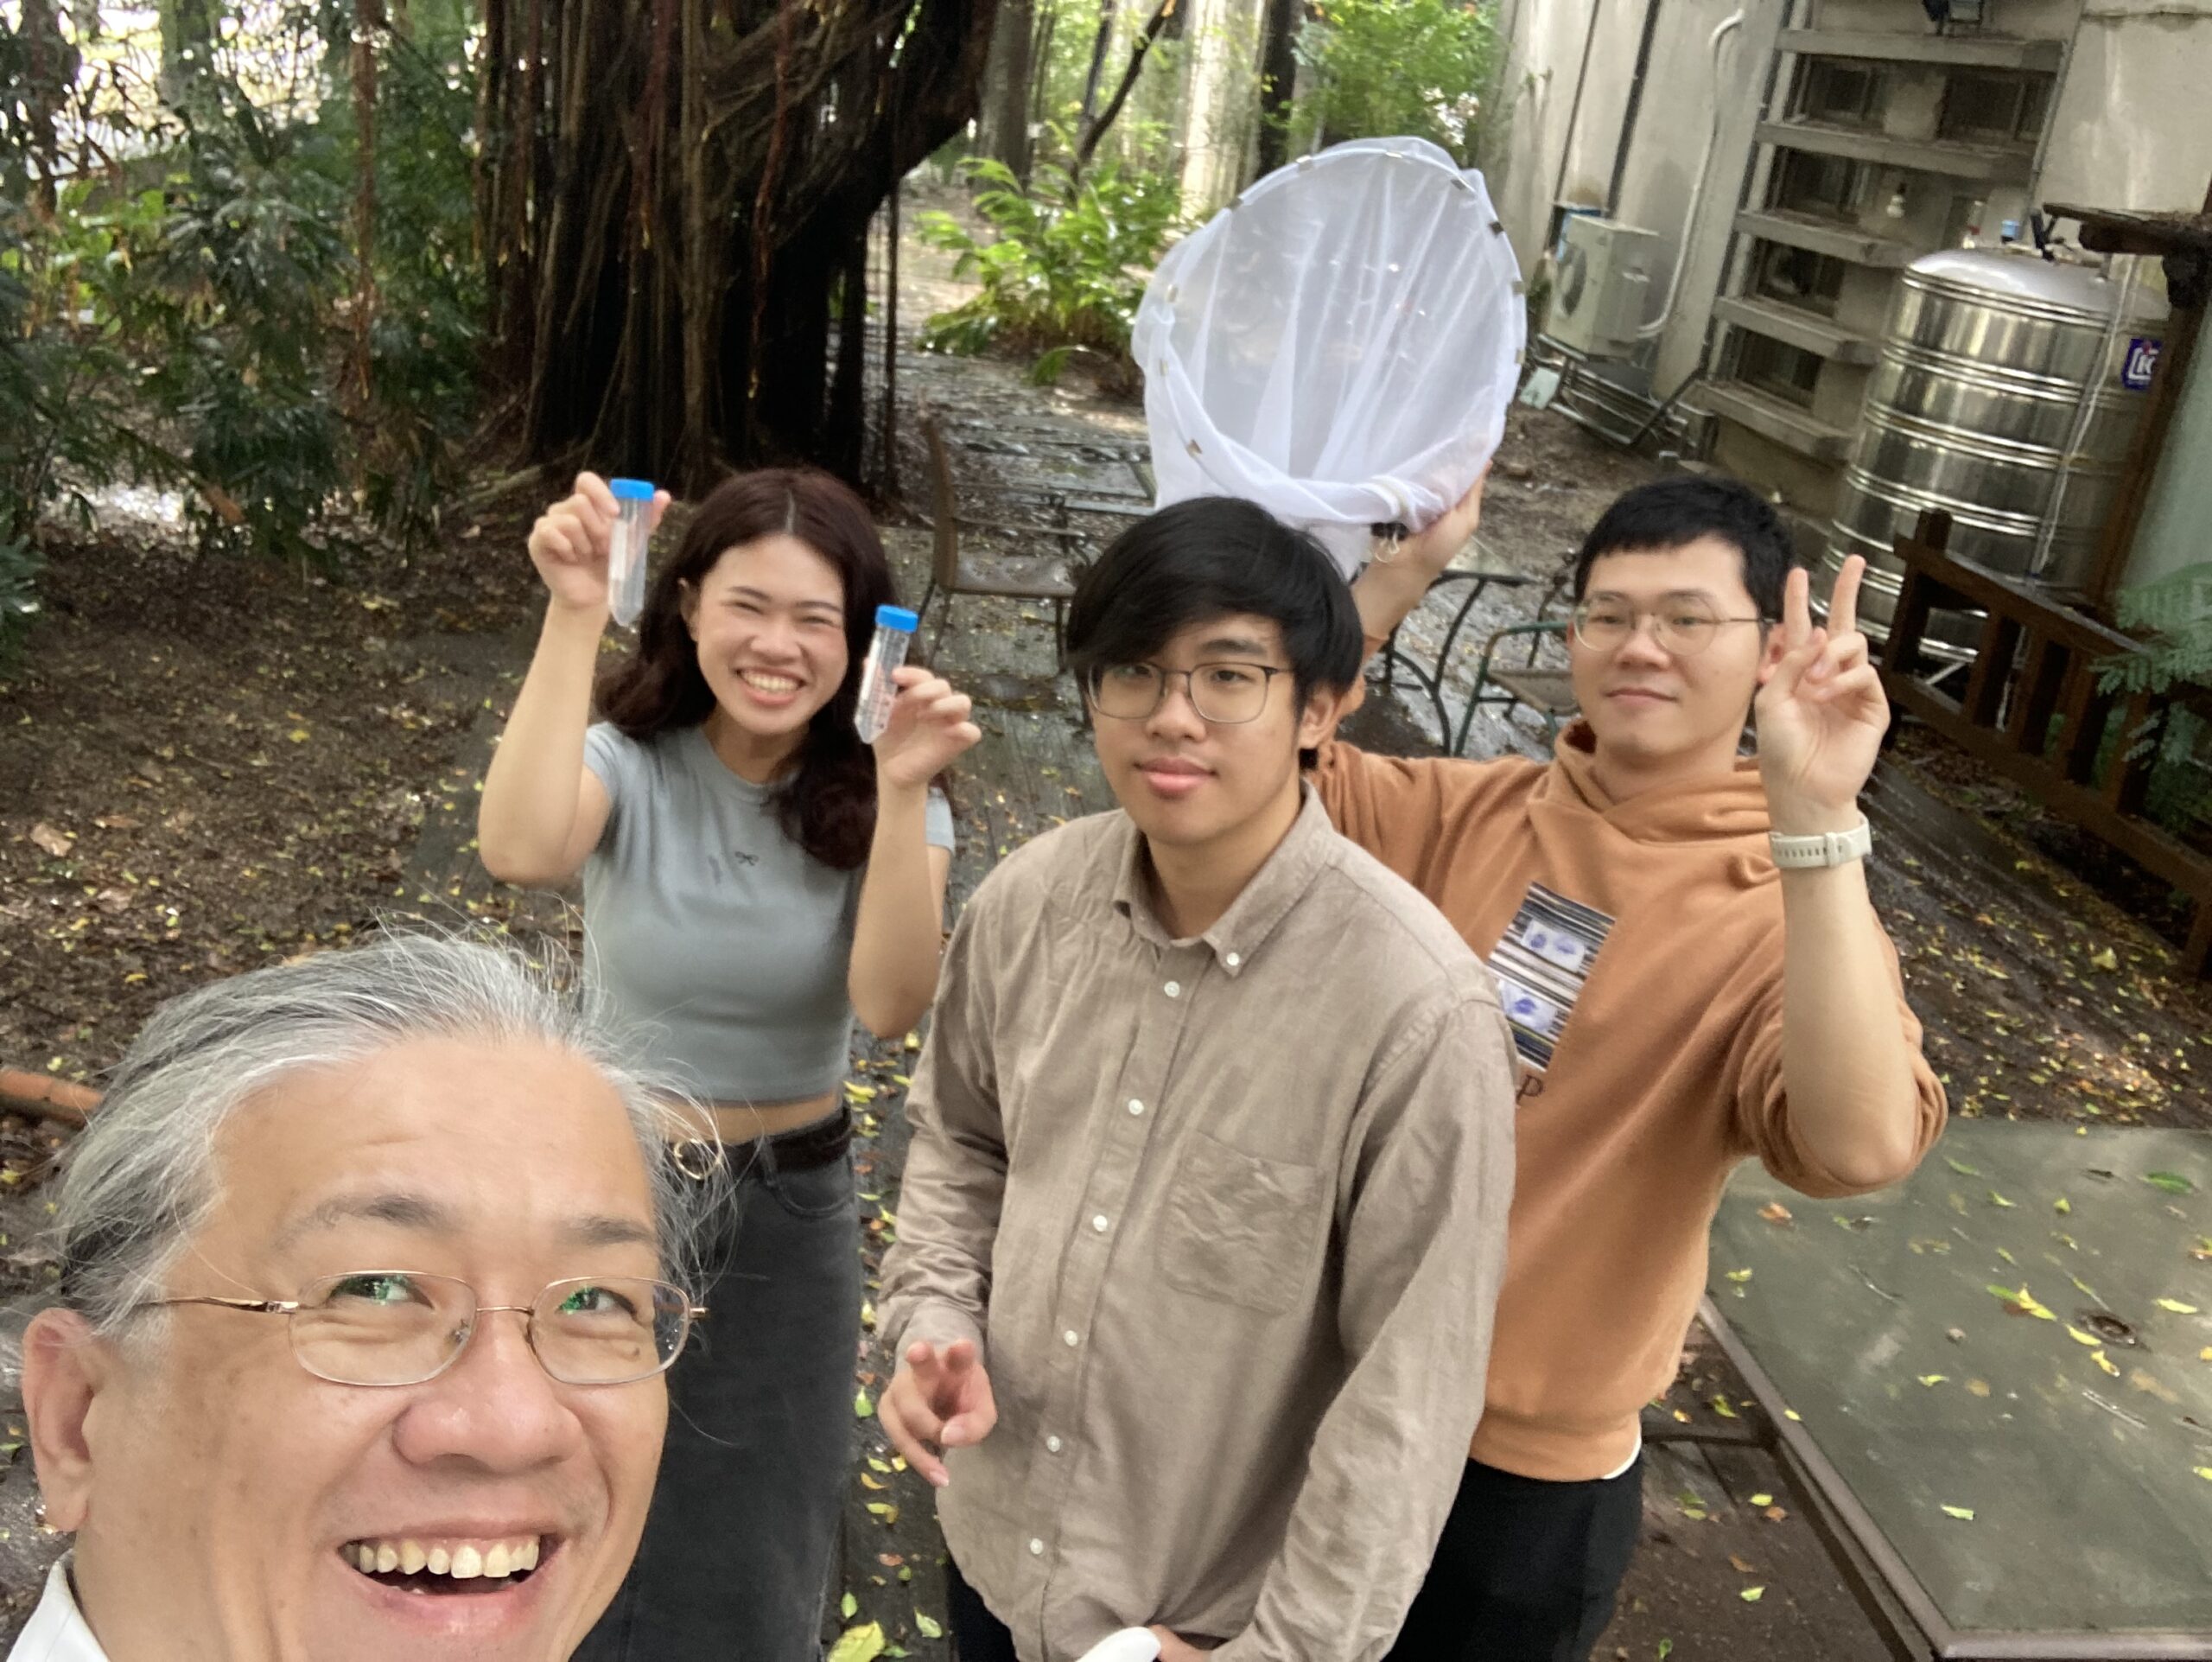
    那天我們在雨中抓蚊子

    有些事情甚至不是在實驗室裡完成的。

    我們曾經為了測試 DNA 萃取的實驗條件,在下著雨的中興校園裡,拿著自製的捕蟲網到處抓蚊子。

    其實有點狼狽。

    但現在回頭看,它反而更接近這個研究真正的樣子——在還沒有答案的時候,先去把問題抓回來。

    當結果開始變得清楚

    當我們將 adaptive sampling 應用在這個系統上時,觀察到一個很直接的變化:

    • 在一般 shotgun sequencing 中,Wolbachia 幾乎不可見(<1%)
    • 在 adaptive sampling 下,Wolbachia 可佔接近 90% 的序列比例

    這不只是 enrichment,而是整體資料組成的明顯改變。

    不只是抓到,而是能夠重建

    在這樣的資料基礎上,我們進一步進行基因體組裝,得到了一個接近完整的 Wolbachia 基因體:

    • 約 1.5 Mb,組裝為兩個 contigs
    • 96–99% completeness
    • 可解析多個 prophage 區域與結構變異

    值得注意的是,即使目標基因體與 reference 之間存在結構差異,adaptive sampling 仍然可以有效運作,並不侷限於完全對應 reference 的區域。

    這代表什麼?

    這項結果顯示,在某些情境下:

    我們或許不需要先將微生物分離或培養,就有機會直接從複雜樣本中取得其基因體。

    對於像 Wolbachia 這類:

    • 無法在體外培養
    • 存在於宿主細胞內
    • 在樣本中比例極低

    的系統,這提供了一種可行的研究方向。

    更廣泛的脈絡

    Wolbachia 並不只存在於蚊子中。它廣泛存在於許多昆蟲與節肢動物體內,是自然界中相當普遍的胞內共生菌。

    在不同宿主之中,Wolbachia 的感染狀態、基因體結構與功能表現,都可能有所差異,這也使得其基因體研究具有相當大的多樣性與挑戰性。

    在這項工作的基礎上,我們目前也正在將這樣的策略,應用到其他昆蟲系統中,嘗試探索不同宿主背景下的Wolbachia 基因體特性。

    這些工作仍在進行中,但也逐漸讓我們看到,這類方法在不同宿主系統中的潛在應用範圍。

    結語

    這個是一段漫長的持續嘗試與修正的過程。

    有些內容就寫在論文裡,至於其它的,就留在那一天的雨中,還有那電腦螢幕上閃爍著綠色格子的無數夜晚吧。

  • 基因體告訴我們的事:關於人類適應型 MRSA CC398

    基因體告訴我們的事:關於人類適應型 MRSA CC398

    Genomic and phylogenetic characterization of human-adapted methicillin-resistant Staphylococcus aureus clonal complex 398 lineages in Taiwan

    Microbiology Spectrum

    https://doi.org/10.1128/spectrum.02090-25

    其實在臨床上談到 MRSA,多半還是把它當成一個「抗藥性很麻煩的細菌」來理解。但如果把時間拉長來看,MRSA 從來就不只是醫院裡的問題,它一直在不同環境之間流動,也在不同宿主之間嘗試適應。

    在開始談這項研究之前,或許還是需要先簡單說明一下,什麼是 MRSA,以及像 CC398 這樣的分類在講什麼。

    MRSA 是 methicillin-resistant Staphylococcus aureus 的縮寫,中文常翻作「抗甲氧西林金黃色葡萄球菌」。金黃色葡萄球菌本來就是一種很常見的細菌,不少人皮膚或鼻腔上都帶著它,多半不會出問題,但在特定情況下,它也可能引起皮膚感染、肺炎,甚至血液感染。所謂 MRSA,指的是其中一群對多種常用抗生素具有抗藥性的菌株,因此在臨床治療上特別棘手。

    隨著基因體技術的進展,研究者逐漸發現,MRSA 並不是單一來源的細菌,而是由許多彼此有親緣關係、但生態背景不同的族群所組成。為了描述這些親緣關係,常會使用「clonal complex(簡稱 CC)」這樣的分類方式。簡單來說,CC 指的是一群在基因體的基本結構上彼此相近、來自同一演化支系的菌株集合。像 CC398,就是 MRSA 家族中的其中一支。

    也正因為這樣,當我們在談 CC398 時,其實不是在談「一株細菌」,而是在談一整個具有共同演化背景、但可能已經分化出不同生態型態的族群。

    在這些不同的 MRSA 家族中,CC398 是一個很有代表性的例子。它最早被注意到時,主要和畜牧環境有關,因此長期被歸類為「動物相關型 MRSA」。在這樣的框架下,人類感染常被視為偶發事件,而不是它的主要生態位。

    這個研究的起點其實很單純。我們整理了台灣中部兩家醫院收集的 MRSA 菌株,在其中辨識出 14 株屬於 CC398 的案例。數量不多,感染型態也不特別戲劇化,但有一件事讓人停下來想了一下:這些病人都沒有明確的畜牧接觸史。如果 CC398 仍然主要來自動物,那這些感染是怎麼發生的?

    答案並不在病歷裡,而是在細菌的基因體中。

    透過全基因體定序,我們把這 14 株 CC398 的「整本說明書」攤開來讀,而不是只用少數標記去分類它們。很快就可以看出,這些菌株其實分成兩群。一群是 ST398,整體樣貌還算接近過去對 CC398 的理解,但已經帶有一些與人類免疫逃避相關的基因,顯示它們正在往人類適應型方向移動,只是仍保有相當程度的多樣性。

    另一群則是 ST1232。這一群在分析時顯得非常一致:幾乎都帶有與嚴重皮膚感染相關的 PVL 毒素,具備完整的人類免疫逃避基因組合,對多種抗生素具有抗藥性,而且在整個基因體結構上高度相似。這樣的特徵,比較不像是零星出現的變異,而更像是一個已經在特定環境中穩定存在、並且持續擴散的族群。

    為了進一步確認這個判斷,我們把台灣的菌株放進國際資料庫中進行比較。結果顯示,台灣的 ST1232 與日本、韓國、澳洲,甚至部分歐洲的人類感染株非常接近。這意味著,它不是台灣特有,也不是最近才出現的型別,而是一個已經在多個地區成功適應人類宿主的 MRSA 支系,只是我們現在才比較清楚地把它辨識出來。

    從基因體的角度來看,這樣的結果並不讓人意外。細菌當然並不可能在意我們如何替它們分類,它們只是在不同宿主與環境之間反覆移動、調整自己。當某一種基因組合真的成功,它就不再只是跨物種的偶發事件,而會成為一個能在人群中穩定流動的族群。這正是人畜共同健康(One Health)概念中最核心、但也最容易被忽略的一點。

    在分析方法上,這項研究並沒有依賴什麼特別花俏的技術,而是全靠我們團隊成員的耐心一步一步把事情看清楚。一方面,我們比較不同菌株在「基本結構」上的相似程度,確認它們在整體親緣關係中的位置;另一方面,也仔細檢視那些較為「流動」的基因片段,例如與抗藥性、毒力或免疫逃避相關的基因,看看它們是否以固定的方式被保留下來。當一群菌株不只骨架相近,連這些功能性模組的組合與位置都高度一致時,通常代表這不是偶然,而是一個已經被自然選擇穩定保留下來的型態。

    從這個角度來看,這篇研究的重點其實不是「發現了一種新的 MRSA」,而是更務實地補上一塊拼圖:在台灣,確實可以看到已經完成「人類適應」的 CC398 支系存在於臨床感染之中。如果仍然只用「畜牧相關 MRSA」的框架來理解 CC398,很容易低估像 ST1232 這樣的族群。

    這個主題主要由博班生吳宗樺醫師,以及已經畢業的碩士生吳詠婕一起完成,更早我們團隊的幾位畢業的碩班生李柔荑、萬美秀、葉文盛也參與並先後提供了協助。對我們團隊而言,這並不是一個追求戲劇效果的題目,而是大量定序、比對與反覆確認的過程。某種程度上,我們團隊的研究生們在這裡做的事情,就是把原本有點模糊的輪廓,一點一點描清楚,讓我們在討論 MRSA 與人畜共同感染時,多了一份來自基因體層級的實證依據。

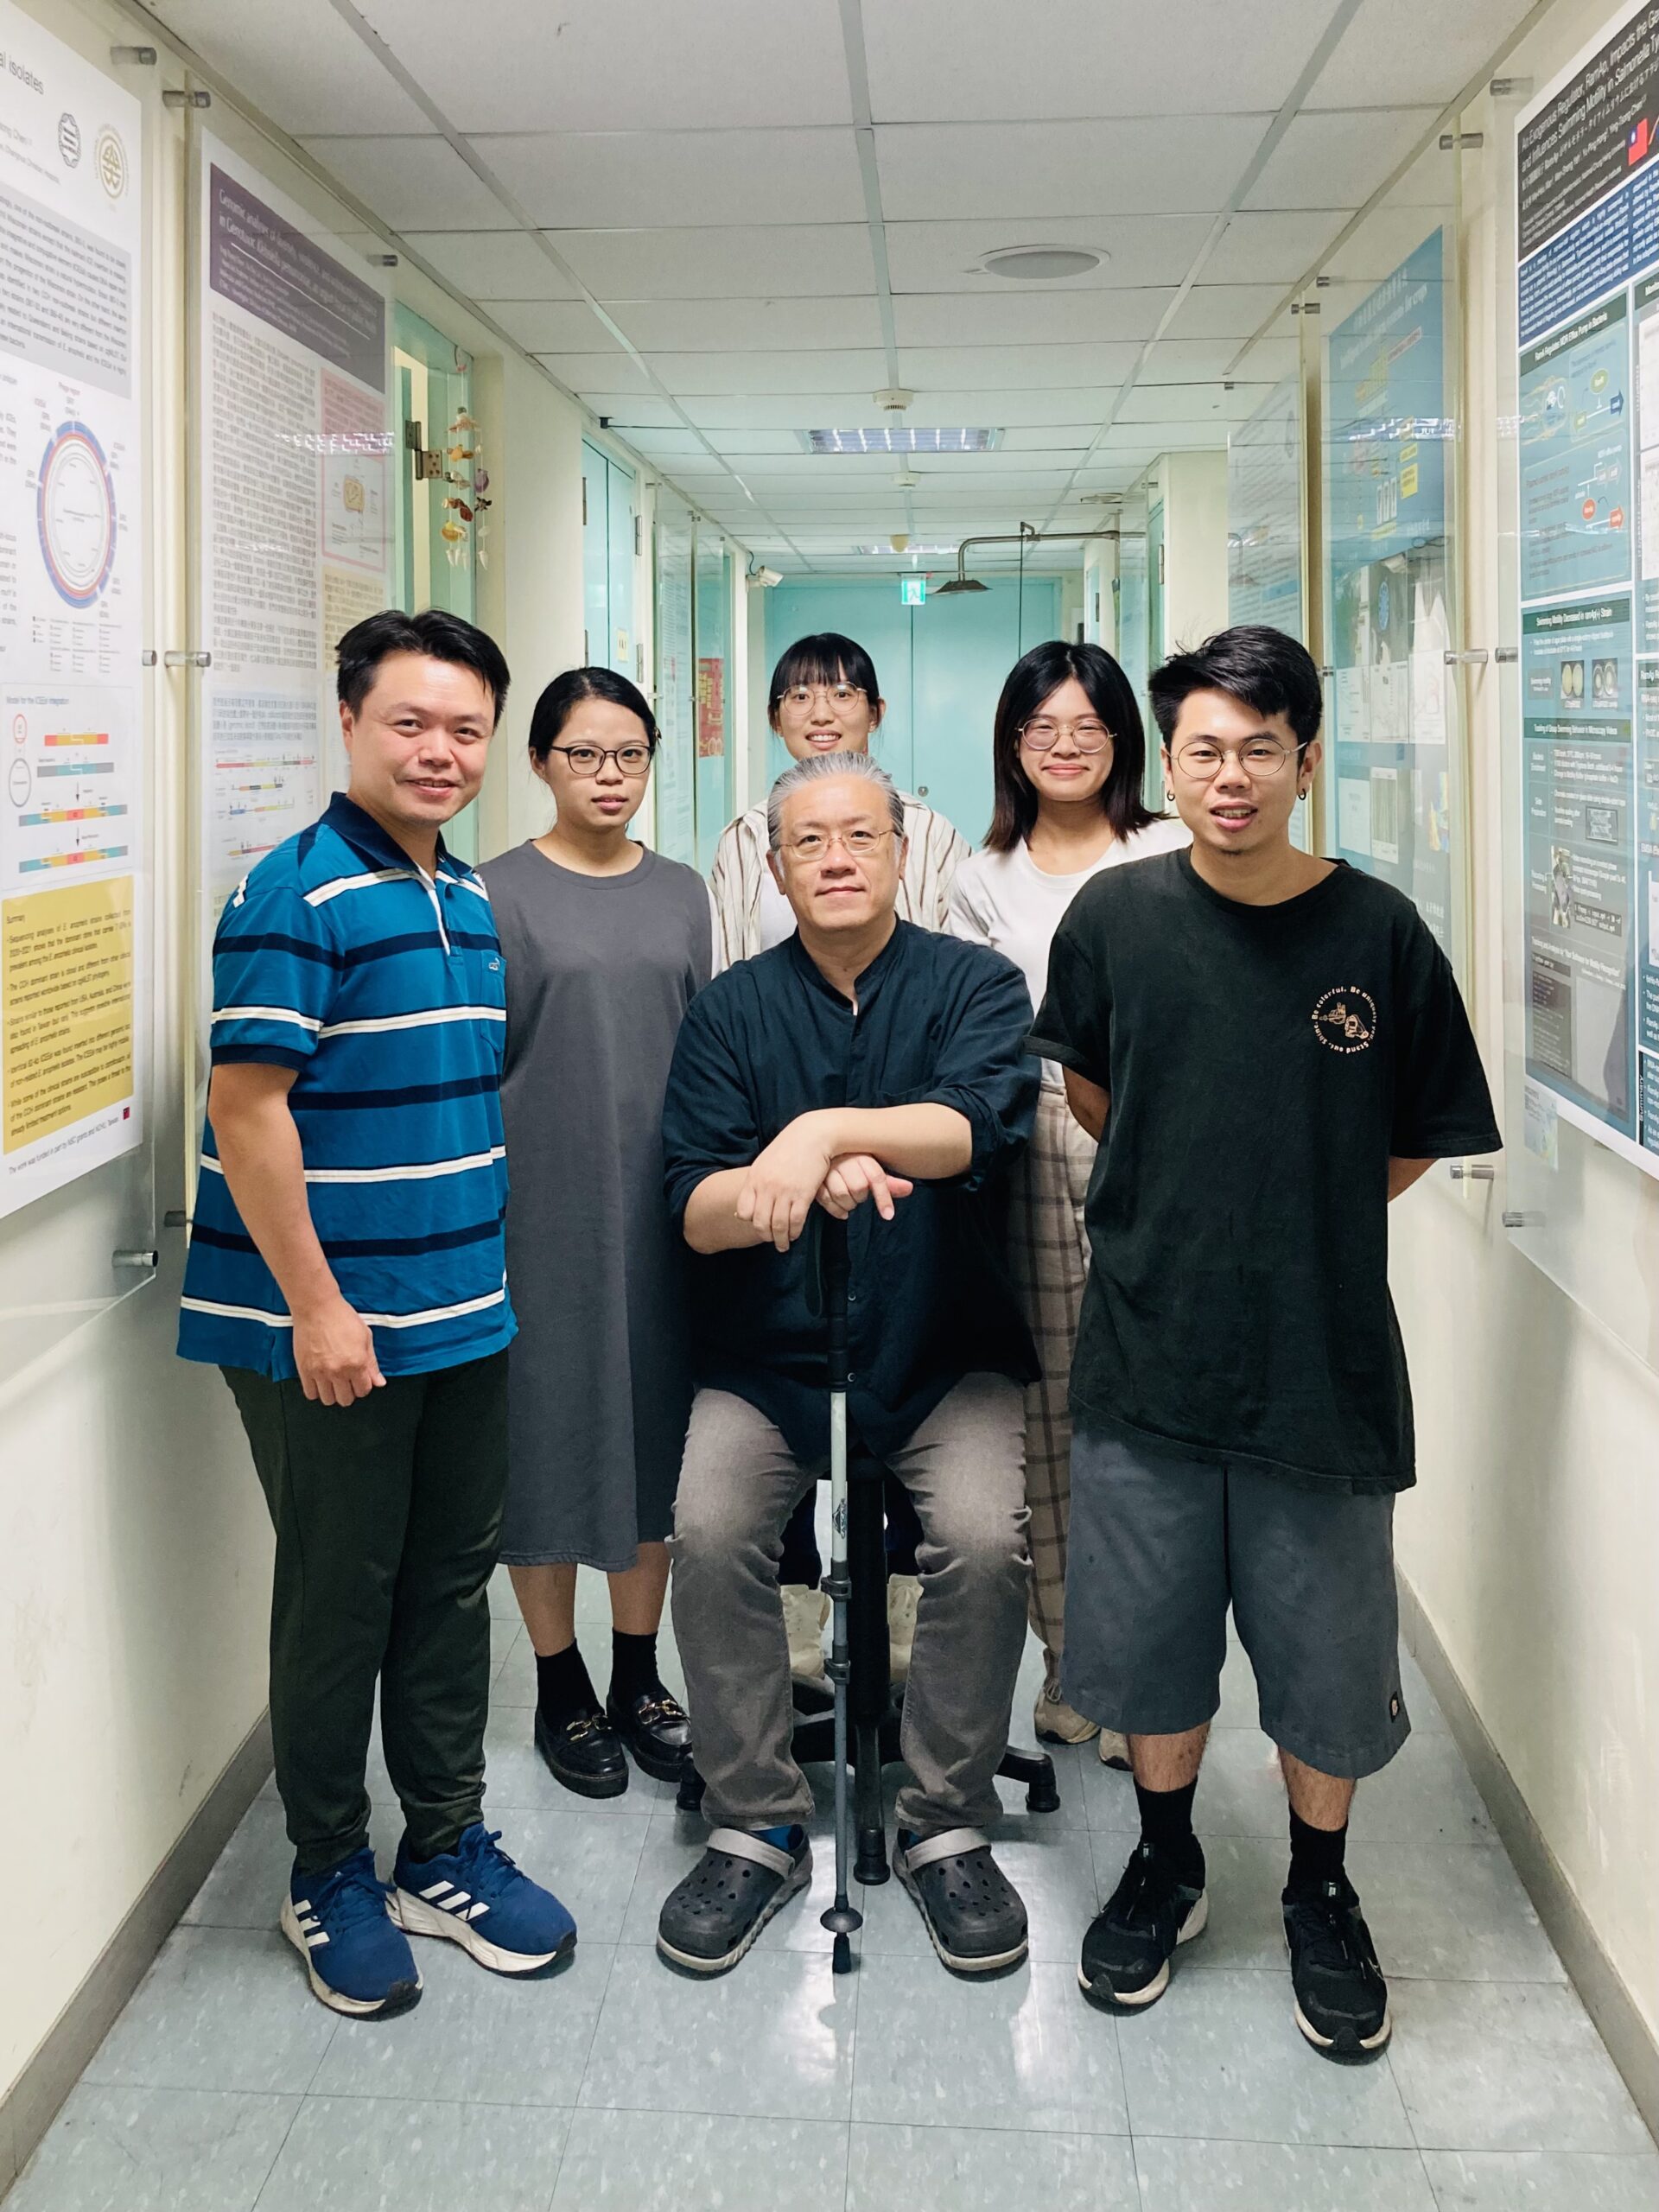
    2024年8月 研究團隊合影

  • Genotoxic Klebsiella pneumoniae in Taiwan

    Genotoxic Klebsiella pneumoniae in Taiwan

    PLoS One. 2014 May 22;9(5):e96292.

    https://pubmed.ncbi.nlm.nih.gov/24852749

    研究在問什麼問題?
    在完成 Klebsiella pneumoniae 1084 的完整基因體定序後,我們注意到其染色體上存在一段結構與功能都相當不尋常的 genomic island。過去多項流行病學研究指出,K. pneumoniae 引起的肝膿瘍與宿主日後罹患癌症的風險之間存在統計上的關聯,但背後的生物學機制並不清楚。本研究關注的是,K. pneumoniae 是否可能透過特定基因體區段,對宿主細胞造成直接的 DNA 層級影響,進而提供一個潛在的解釋。

    使用了什麼方法?
    我們首先在 K. pneumoniae 1084 的全基因體序列中,辨識出一段長約 208 kb 的 genomic island(命名為 KPHPI208),其中包含與 Escherichia coli pks gene cluster 同源的 colibactin 生合成模組。為確認該基因區段是否具有功能性,我們結合分子生物學與細胞實驗,進行 clbA 基因的缺失與互補分析,評估其是否與宿主細胞 DNA 損傷相關;同時,也利用 PCR 調查台灣臨床 K. pneumoniae 分離株中 pks gene cluster 的盛行率。

    這篇研究的主要貢獻
    研究結果顯示,K. pneumoniae 1084 所攜帶的 KPHPI208 由多個功能模組組成,其中一個模組與 E. coli 的 colibactin gene cluster 完全相同。在細胞實驗中,1084 感染肝細胞後可誘發 DNA 損傷的指標反應(H2AX 磷酸化),而刪除 clbA 後該現象消失,並可在互補後恢復,證實該基因簇具有實際的 genotoxic 活性。進一步的臨床株分析顯示,台灣分離的 K. pneumoniae 臨床株中約有 25.6% 攜帶 pks gene cluster,比例明顯高於歐洲報告,且與 K1 血清型高度相關。

    整體而言,這項研究首次在台灣臨床 K. pneumoniae 中系統性地證明 pks/colibactin gene cluster 的存在與功能,並提出 K. pneumoniae 可能不僅透過傳統毒力因子致病,亦可能在感染過程中對宿主細胞造成基因體層級的損傷,為過去觀察到的肝膿瘍與癌症風險之間的關聯,提供一個具有生物學基礎的假說。

  • Nanopore的魚類圖鑑

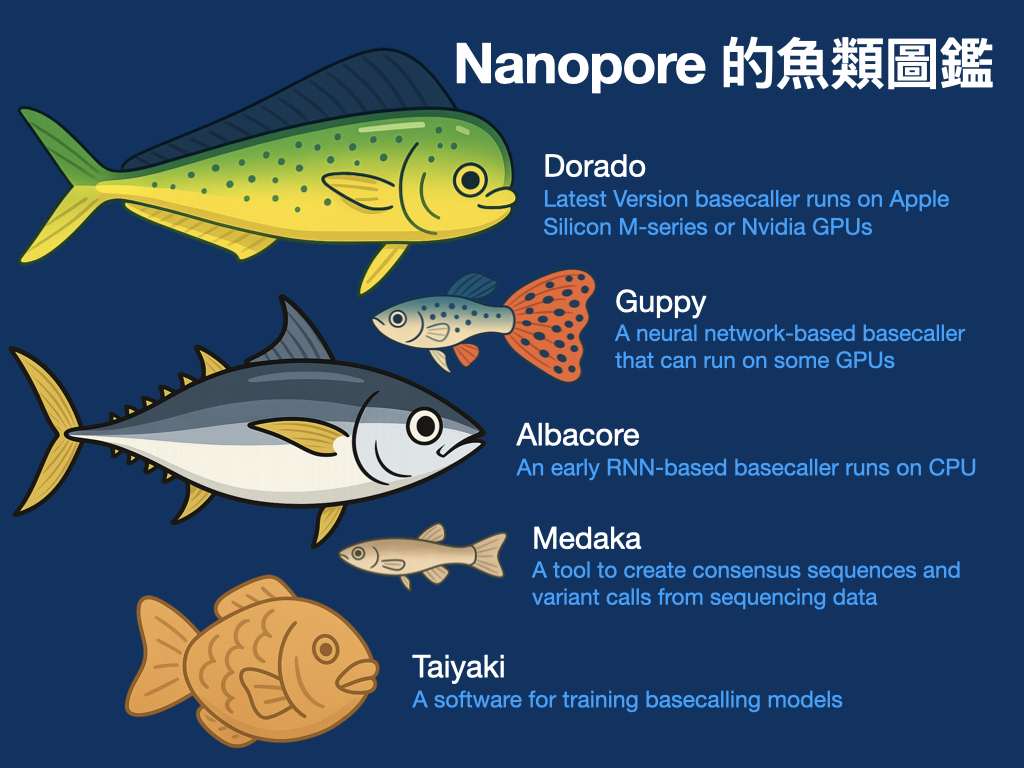
    大家知道一直以來我們做Nanopore Sequencing 會接觸到的許多軟體其實都是用魚的名字命名的嗎?(如果鯛魚燒也算的話)

    原本只是作Nanopore定序,沒想到意外開啟了「魚類小圖鑑」之路。從長鰭鮪魚, 孔雀魚, 竹筴魚, 鬼頭刀到鯛魚(燒)等等,這些原本對我們做細菌的來說只是陌生的英文單字,現在竟然變成了熟悉的水中夥伴。誰會想到,一個做基因體生物資訊的人,最後記住魚的名字不是因為接觸魚類生態課,也不是釣魚,而是因為…軟體。學習的路上常常充滿意外的收穫,而這些魚的名字,也為我們在實驗室的工作多增添了幽默感和生命力。

    (more…)
  • CulebrONT安裝筆記(新)

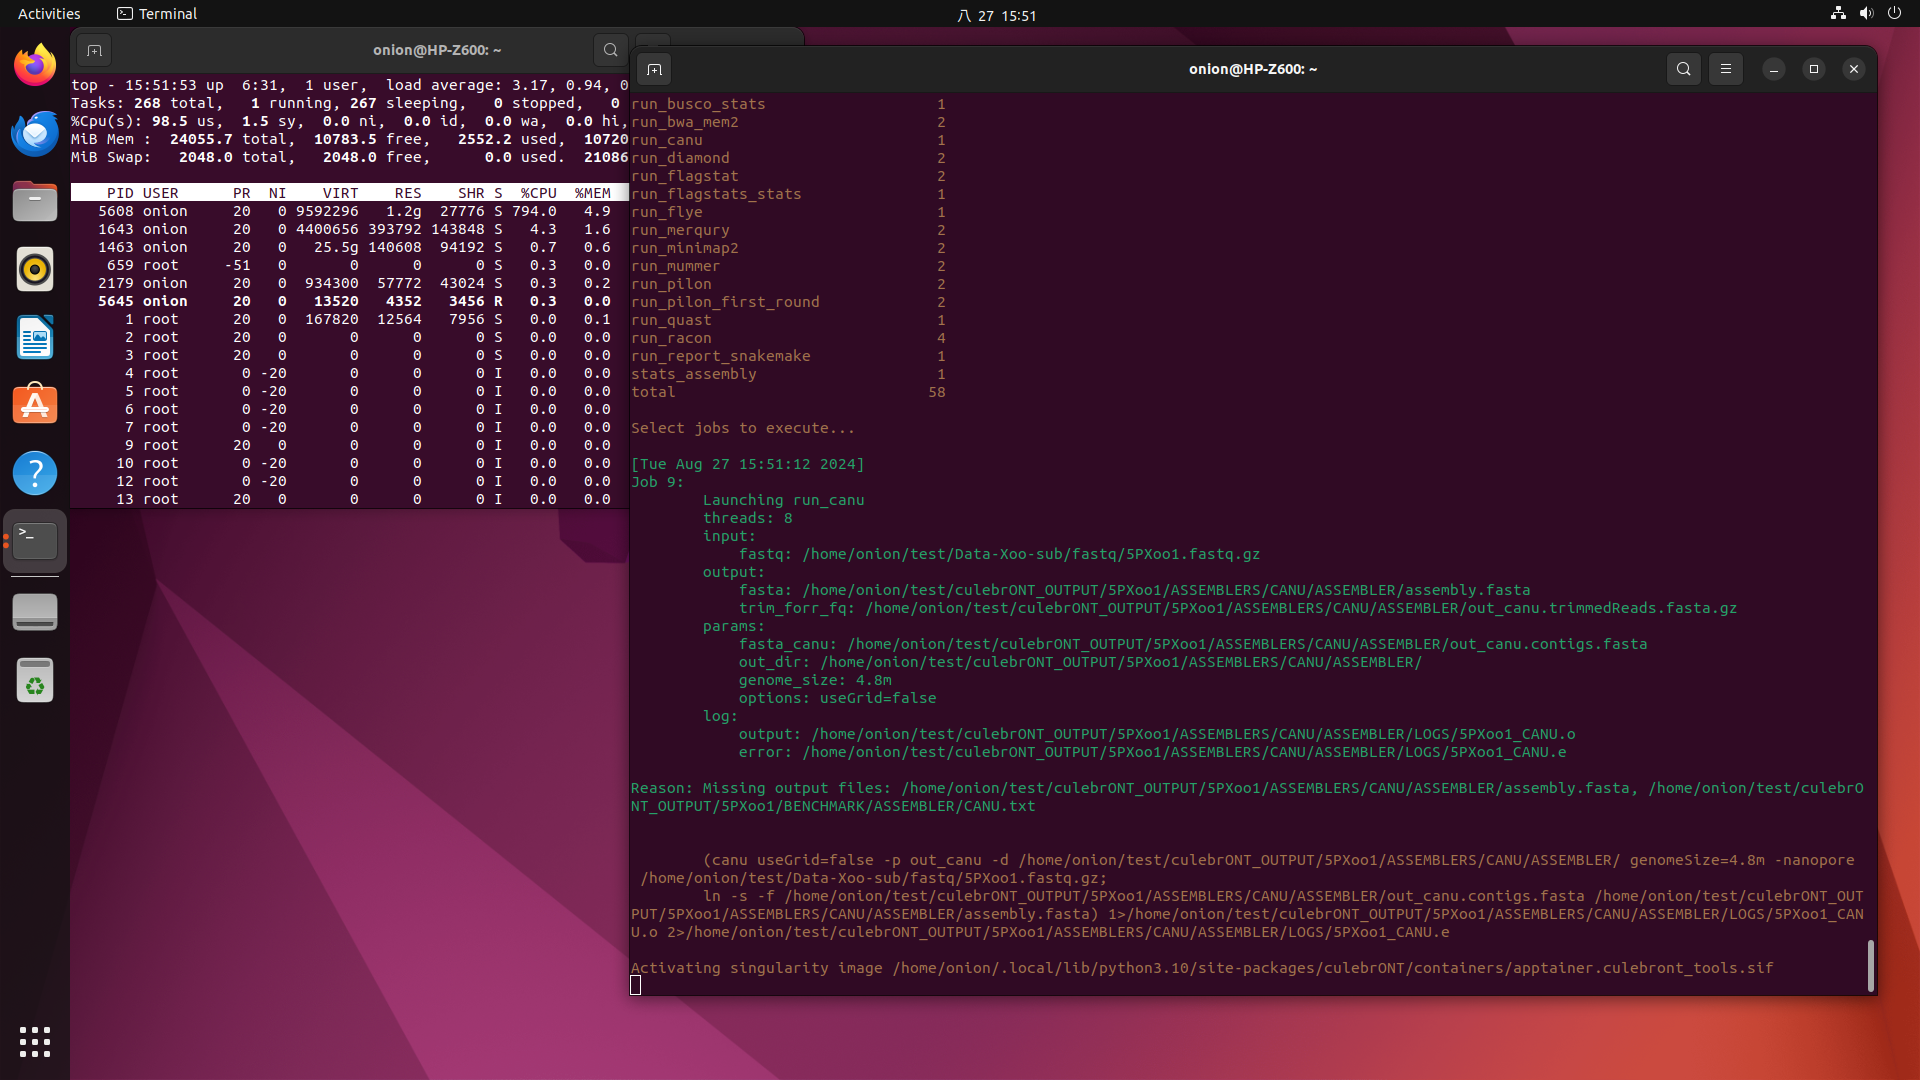
    現在拿長序列做基因體的散彈槍定序組裝,可以用的生物資訊工具真的很多。問題是,選用怎樣的工具組裝比較好?這個叫做culebrONT的開源Snakemake pipeline是一個很有用的東西,他可以用來運行各種的散彈槍定序組裝的生物資訊工具、修正(polishing)、甚至於(有必要的話)把序列圈起來等等,幫助你進行各種方案間的比較,讓使用者可以建構適合自己的理想工作流程。以下是我們在舊的Z600電腦工作站上重新安裝culebrONT的筆記。

    安裝作業系統

    我們這台是修修補補過的HP Z600老電腦工作站,硬體規格是Xeon E5620x2 8 cores 24GB DDR3-1333 ECC Registered RAM (4GB*6) 1TB SATA SSD Nvidia GTX 1080 8GB。首先是安裝Linux作業系統,我們要在1TB的SSD上面安裝的作業系統是Ubuntu 22.04.4 LTS (Jammy Jellyfish),準備工作:

    先從官網下載它的64-bit PC (AMD64) Desktop Image iso (ubuntu-22.04.4-desktop-amd64.iso),然後用balena etcher寫到USB flash disk上 (超過5Gb的容量)。

    用做好的USB flash disk開機進行安裝。從GRUB選單中,選擇Try or Install Ubuntu,語系選English,Install type選Normal Installation,核取Download updates while installing Ubuntu以及Install third-party software for graphics and Wi-Fi hardware and additional media formats。

    下一個選單,因為這個SSD裡面的東西已經不要了,我們選取Erase disk and install Ubuntu。

    選地區、建立使用者名稱密碼。進行安裝。完成之後,重新開機,系統會提醒你取出USB flash disk。

    第一次開機進入Ubuntu Desktop之後,首先做系統更新:

    sudo apt-get update

    安裝R

    關於R的安裝,參考https://cran.r-project.org ,步驟如下:

    安裝Graphviz

    Graphviz: https://graphviz.org/download/

    安裝GO

    參考這篇的作法

    創建一個目錄結構,以將Singularity的原始碼放在正確的位置。然後cd切換到Singularity原始碼的目錄。

    安裝Singularity

    以上步驟出現錯誤,發現需要先裝git,所以

    然後再做一次編譯,發現還需要autoconf, lib tool, glib-2.0, fuse, libfuse-dev,所以先用sudo apt-get install以上這些套件,然後再重新編譯就可以成功了。

    如果以上都順利通過,那就是最後一步!將Singularity安裝到系統中。

    用singularity version看看:

    下載與安裝culebrONT

    這裡發現需要先安裝pip,所以

    sudo apt install python3-pip

    然後再重做一次python3 -m pip install ….
    他會需要下載超過4GB的內容,所以可以在這裡擺著。(最好大清早做這件事,網路速度比較快)

    等待…..

    另外,我發現這個Ubuntu 22.04有個問題,就是安裝之後我就一直找不到它的”Settings”
    這個問題好像早就有不少人遇到過了,解決的方法就是重新安裝settings,我們另外開一個terminal:

    就可以了。

    測試

    裝好之後可以裝測試數據來跑看看,首先下載測試用的數據到test資料夾:

    開始測試:

    我這裡test放在/home/onion/底下,我用的是:

    跑下去才知道這台老電腦真的好慢好慢ㄟ…. 🙂

    結語:電腦硬體老舊似乎真的是跑不動的。我們把這個新安裝好的SSD搬到另一台電腦(Xeon E2236 32G RAM RTX4000)上跑test data就OK了!

    附註:這次新安裝的Ubuntu 22.04不知為何(有人說也許apt-get更新就會好)沒有顯示桌面圖示,但我們這樣解決的: